على مدار سنوات، اختُزل سباق الذكاء الاصطناعي في ثلاثة أسئلة: من يبني النموذج الأكبر؟ من يملك العدد الأكبر من وحدات معالجة الرسومات؟ ومن يصل إلى الريادة التقنية أولًا؟ لا شك أن هذه العناصر جزء من المعادلة، لكنها ليست ما يصنع الفارق الحقيقي.
في الثاني عشر من سبتمبر، نشر داريو أمودي مقالًا بعنوان “علينا ضبط وتيرة تطور الذكاء الاصطناعي”، دعا فيه قطاع الذكاء الاصطناعي إلى إبطاء وتيرة تطور قدرات النماذج بصورة متعمّدة، حتى يتسنى لجهود مواءمة النماذج وضمان سلامتها مواكبة هذا التطور. واقترح أمودي ثلاث خطوات: الاستعانة بجهات تقييم مستقلة بصورة دائمة، وإقامة آلية للتنسيق بين الشركات الرائدة في تطوير الذكاء الاصطناعي في البلدان الديمقراطية، وصولًا في نهاية المطاف إلى تنسيق عالمي شامل. وأعلن أمودي التزام Anthropic بالخطوة الأولى دون انتظار اتفاق جماعي. وبعد ساعات فقط، أيّد ديميس هاسابيس هذا التوجه، ثم تبعته OpenAI.
تأمل ما تعنيه الخطوة الأولى في جوهرها؛ فهي لا تتعلق باكتشاف بحثي جديد، ولا بوضع حد للقدرات الحاسوبية، ولا بإبرام معاهدة. إنها التزام بإخضاع الأنظمة للتقييم المستقل: منح جهات مستقلة إمكانية الوصول الدائم وبالصلاحيات ذاتها التي يتمتع بها موظفو الشركة، حتى يتسنى لأطراف لم تشارك في بناء النظام التحقق من صحة الادعاءات المتعلقة بقدراته وأدائه.
هذه هي النقطة التي أريد من المنطقة التوقّف عندها وتأمّلها. فالشركات الرائدة في تطوير الذكاء الاصطناعي نفسها ترى أن “الاستجابة لتسارع وتيرة التطور” ليست في تقليل ما تطوّره من أنظمة، بل في إخضاع الأنظمة لمزيد من القياس وفق آليات شفافة، وعلى أيدي جهات لا مصلحة لها في نتائج التقييم.
إن السيادة، متى فهمناها حق الفهم، ليست سوى المبدأ ذاته مطبّقًا في سياق جغرافي مختلف؛ فهي لا تعني الانعزال، ولا تعني كبح مسيرة التقدم، بل تعني امتلاك القدرة على التقييم والتدقيق وتكييف الأنظمة، والرفض متى دعت الحاجة إلى ذلك، وفق شروطك أنت، وبلغتك أنت، وعلى أرضك أنت.
وفي بقية المقال، نستعرض لماذا لا تمثل هذه القدرة بالنسبة للغة العربية مجرد خيار سياسي، بل ضرورة تقنية لا غنى عنها. جميع الأرقام الواردة أدناه متاحة للعامة، ويمكن إعادة التحقق منها.
1. فجوة التمثيل ليست مجرد قضية للنقاش؛ بل واقع يعكسه توزيع البيانات
العربية هي اللغة الأولى لأكثر من 400 مليون شخص، لكن حضورها في الفضاء الرقمي لا يعكس هذا الحجم. ففي يونيو 2026، أظهرت بيانات W3Techs أن اللغة العربية تمثّل لغة المحتوى في 0.6% من المواقع الإلكترونية التي تمكّنت المنصة من تحديد لغة محتواها، مقابل 49.7% للغة الإنجليزية.
حصة اللغة من المواقع الإلكترونية ليست سوى مؤشر تقريبي ومحدود لحضورها على الإنترنت. فهي لا تعكس بالكامل حجم المحتوى المتداول عبر تطبيقات المراسلة، والمحتوى الصوتي، وتعليقات الفيديو، والمنصات المغلقة، فضلًا عن الكم الهائل من المحتوى العربي الذي لا يتحول أصلًا إلى صفحات مفهرسة. لكن هذا المقياس، على محدوديته، يقترب من صورة توزيع البيانات التي تُدرَّب عليها النماذج العامة. وعندما يكون محتوى الويب العام هو المادة التي تتعلم منها النماذج في مرحلة التدريب المسبق، فإن لغة لا تشكل سوى 0.6% من هذا المحتوى لن تكون ضمن أولوياتها؛ بل تصبح تفصيلًا هامشيًا يتعلم النموذج تمثيله بصورة تقريبية.
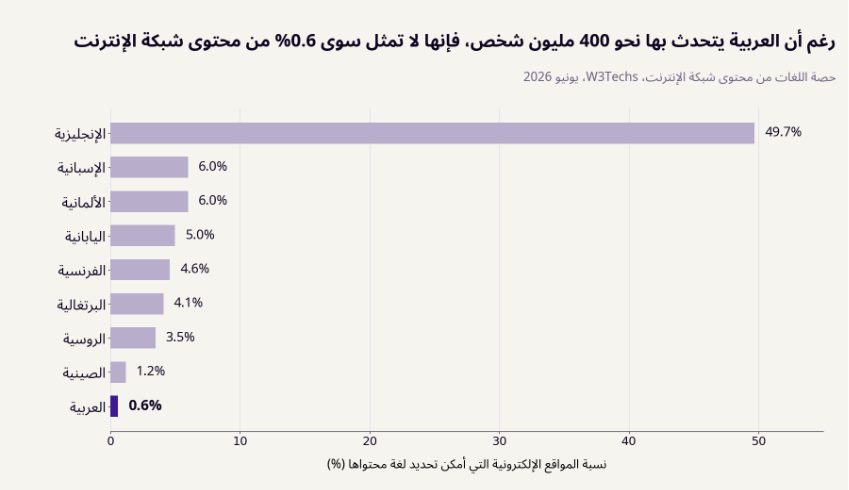
الشكل (1) — توزيع المواقع الإلكترونية حسب لغة المحتوى. المصدر: W3Techs، يونيو 2026.
تلك هي الحقيقة الأولى التي تحجبها عنا عبارة “دعم اللغة العربية”؛ فمجرد القدرة على التعامل مع نظام الكتابة العربي لا يعني إتقان اللغة العربية.
2. قبل أن يتمكن النموذج من الاستدلال بالعربية، عليه أولًا أن يفكك بنيتها
العربية لغة ثرية ببنيتها الصرفية. فالمعنى لا يتحدد بترتيب الكلمات، كما هو الحال في الإنجليزية، بل تنسجه الجذور والأوزان واللواحق وعلامات التشكيل الاختيارية؛ فأداة صغيرة تكفي لقلب معنى الجملة رأسًا على عقب، بينما قد يؤدي غياب علامة تشكيل واحدة إلى تغيير معنى الكلمة تمامًا.
لا تستوعب أدوات تجزئة النص المصممة للإنجليزية هذه البنية العربية جيدًا، وتكشف الأرقام عن تكلفة ذلك بوضوح. فعند اختبار أداة تجزئة النص في نموذج LLaMA 2 على مجموعة البيانات العربية نفسها التي تضم 39 مليون كلمة، تُقسَّم الكلمة العربية في المتوسط إلى 5.38 وحدة، ولا تحتفظ الأداة إلا بنسبة 1.8% من الكلمات العربية في صورة وحدات كاملة. لكن الصورة تتغير جذريًا مع أداة تقسيم مخصصة للعربية. فعلى مجموعة البيانات ذاتها، تنخفض النسبة إلى 1.71 وحدة لكل كلمة، بينما تحتفظ الأداة بنسبة 63.23% من الكلمات في صورة وحدات كاملة. والنتيجة أن ترميز المجموعة بأكملها يتطلب 66.55 مليون وحدة فقط، بدلًا من 210.03 مليون وحدة، بانخفاض يقارب 68%.
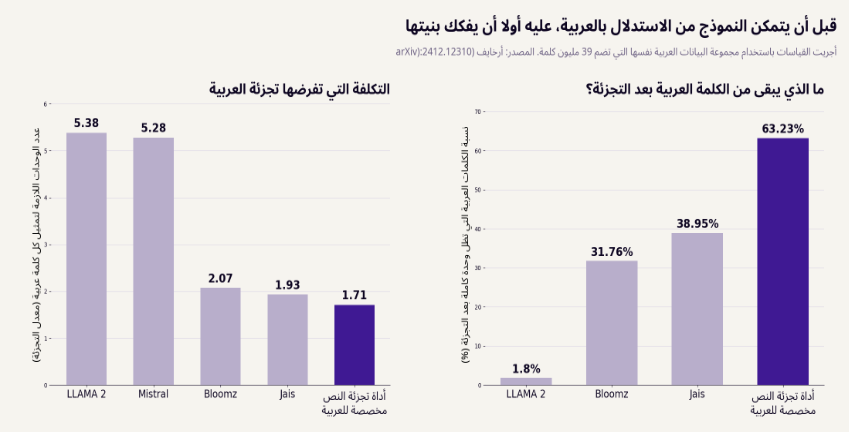
الشكل (2) — معدل تجزئة الكلمات إلى وحدات ونسبة الكلمات العربية التي بقيت كاملة، باستخدام مجموعة البيانات نفسها التي تضم 39 مليون كلمة. المصدر: أرخايف (arXiv): 2412.12310.
وتترتب على ذلك نتيجتان واضحتان، وكلتاهما تنعكسان مباشرةً على الشركات والمؤسسات.
تتعلق النتيجة الأولى بالتكلفة وسعة السياق. فعندما يتطلب النص العربي نفسه نحو ثلاثة أضعاف عدد الوحدات، ترتفع تكلفة الاستنتاج والضغط على الذاكرة إلى ثلاثة أضعاف، وتنخفض كمية المحتوى التي تستوعبها نافذة السياق إلى الثلث.
أما النتيجة الثانية، فهي أقل وضوحًا، لكنها أشد تأثيرًا. تشير دراسات حديثة قارنت بين اللغات إلى أن أدوات تجزئة النص المدمجة في النماذج تنتج في العربية نحو 2.4 وحدة لكل كلمة، مقابل 1.5–1.6 في الإنجليزية. ومع ازدياد طول المدخلات وتعقيدها، يصاحب هذه التجزئة تراجع أكبر في أداء النموذج. ولذلك، قد يحقق النظام أداءً جيدًا عند التعامل مع أمر قصير، لكن الصورة تتغير تمامًا عندما تضع بين يديه عقدًا من 40 صفحة.
3. الفجوة هيكلية، وليست مشكلة في توزيع الوحدات
قد يُقال إن المشكلة ببساطة هي أن العربية لا تحصل على حصة كافية من مفردات الوحدات. فإذا مُنحت العربية حصة أكثر إنصافًا من مفردات هذه الوحدات، فستنتهي المشكلة.
لكن المشكلة لا تزول. فقد اختبر الباحثون هذه الفرضية تحديدًا باستخدام أداة لتجزئة النص متعددة اللغات، بعد معالجة التحيّز فيها وتوزيع وحدات قاموسها بإنصاف بين اللغات. وجاءت معدلات التجزئة في مختلف اللغات قريبة من 1.0، مما يؤكد أن التوزيع كان عادلًا. ومع ذلك، ظلت العربية تعاني من التجزئة ذاتها؛ إذ لم يتجاوز مؤشر الاتساق بين الوحدات والمقاطع الصرفية 0.10 في العربية، مقابل 0.42 في الإنجليزية، كما أن 89% من الوحدات العربية لم تحمل أي محتوى دلالي، مقابل 58% في الإنجليزية.
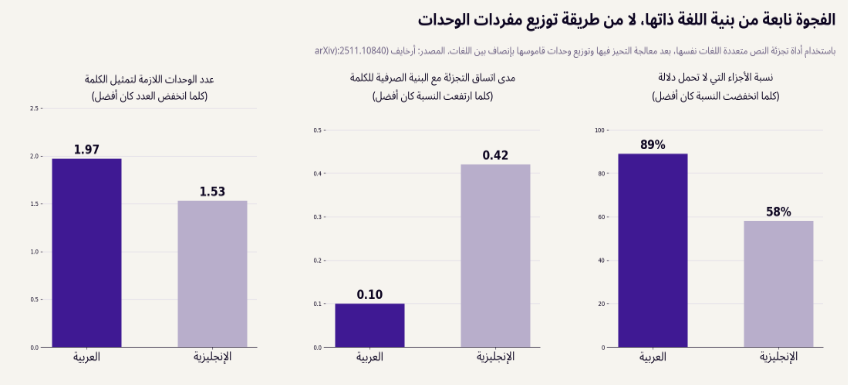
الشكل (3) — مقارنة بين العربية والإنجليزية باستخدام أداة لتجزئة النص متعددة اللغات، بعد معالجة التحيّز فيها وتوزيع وحدات قاموسها بإنصاف بين اللغات. المصدر: أرخايف (arXiv): 2511.10840.
بعبارة بسيطة: حتى عندما نمنح العربية حصة سخية من مفردات الوحدات، فإن المشكلة تظل قائمة؛ إذ تستقر حدود هذه الوحدات في مواضع غير مناسبة داخل الكلمات العربية، لأن البنية الصرفية للعربية لا تتوافق مع الطريقة التي تبحث بها خوارزمية مصممة على أساس الإنجليزية عن مواضع التقسيم. فكلمة “Radar” تتجزأ إلى بادئة ووسط ولاحقة، بينما تُجزَّأ كلمة “Inspect” من دون مراعاة حدود وحداتها الصرفية، فتنتج عنها أجزاء لا تحمل أي معنى.
لا يمكن حل هذه المشكلة باستخدام نموذج أكبر، فحلها يبدأ من الأساس: بناء منظومة مصممة وفق خصائص اللغة، بدءًا من طبقة تمثيلها، وهو ما يتطلب جهودًا متكاملة في مجالات الهندسة والبيانات وبناء الكفاءات، لا مجرد قرار بالحصول على ترخيص.
4. المخرجات الفعلية للتقييمات المعيارية
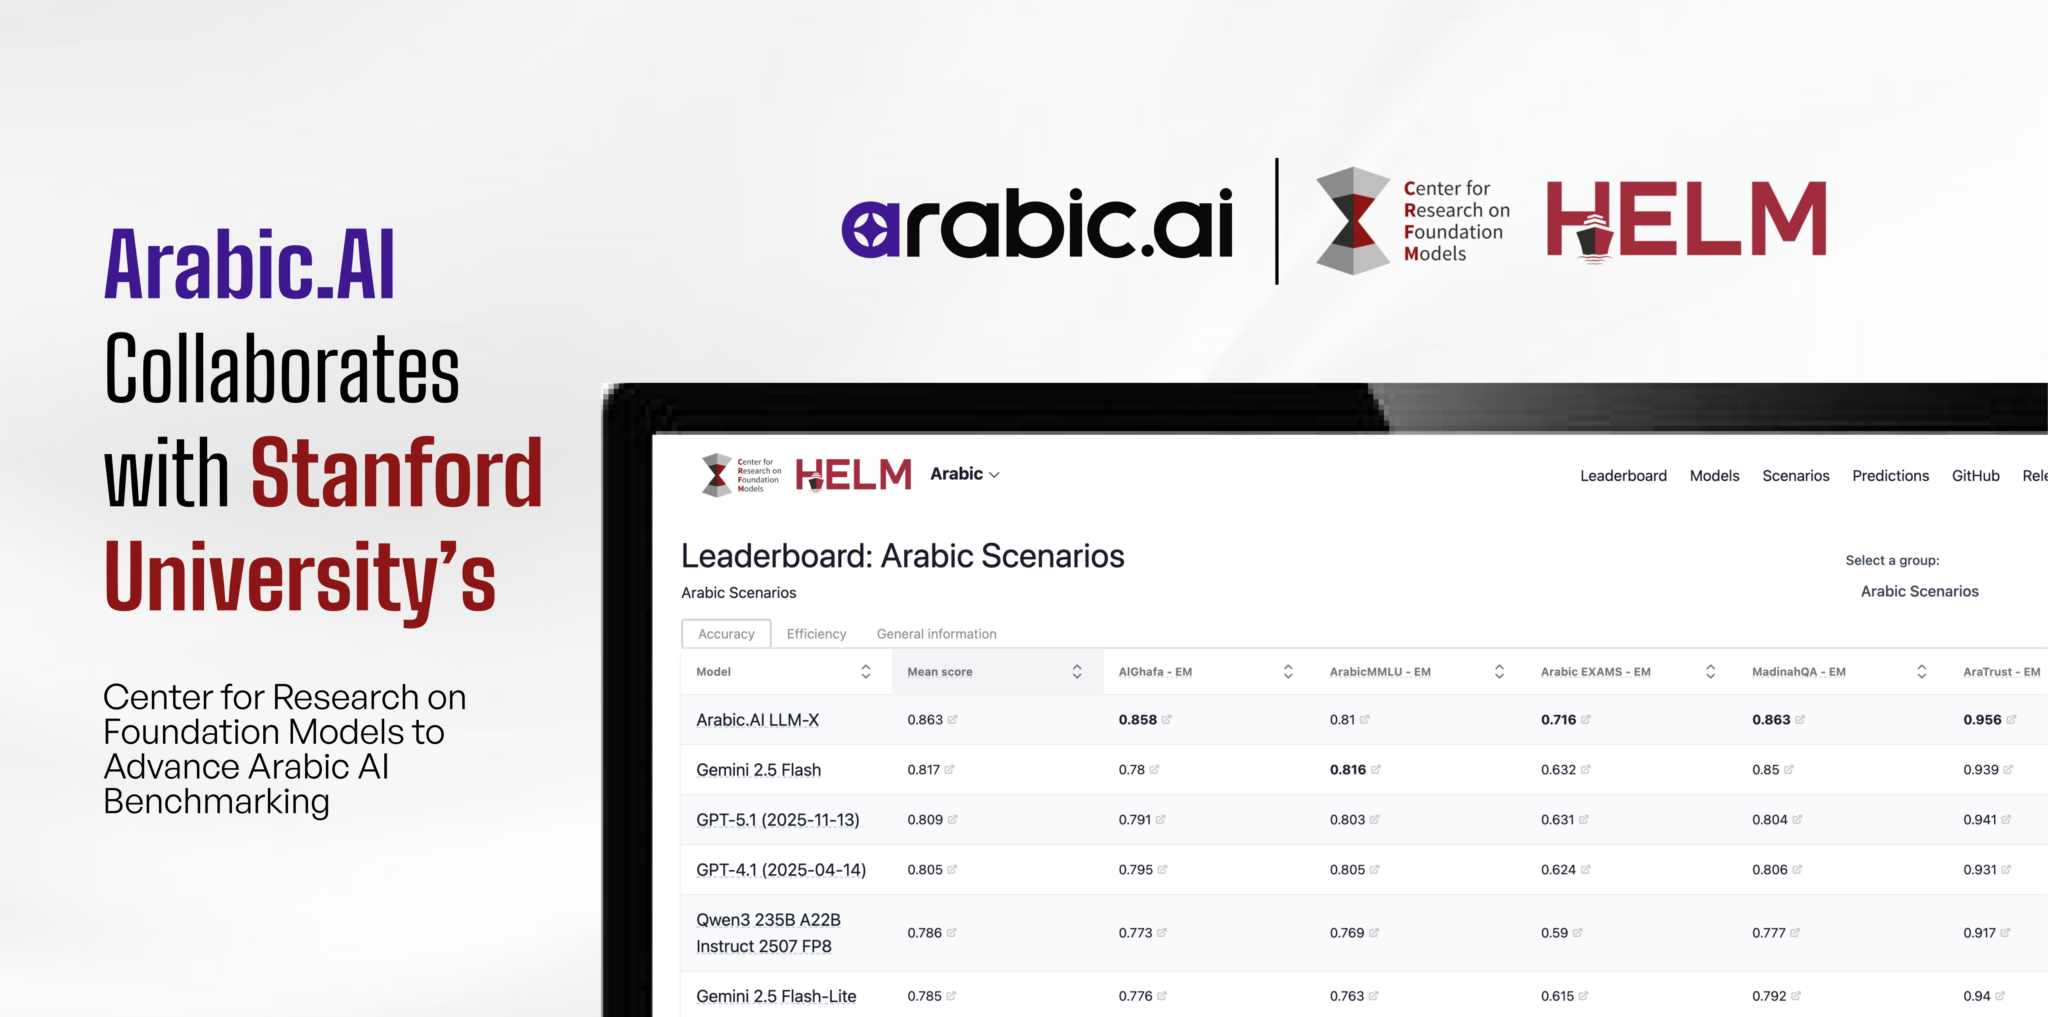
في مايو 2026، نشر مركز أبحاث النماذج الأساسية بجامعة ستانفورد نتائج إطار تقييم النماذج اللغوية العربية الكبيرة “HELM Arabic Enterprise”، الذي يقيّم أداء النماذج في ست مهام مؤسسية باللغة العربية: إنشاء المقالات، وثلاثة أنماط من مهام فهم وتحليل البيانات المالية، والإجابة عن الاستفسارات القانونية في دولة الإمارات في حالتي إتاحة المراجع ومن دونها. وقد سُجّلت جميع الأوامر، والاستجابات، ومقاييس التقييم، والنتائج، ويمكن إعادة التحقق منها من خلال إطار “HELM” مفتوح المصدر. شاركت شركة Arabic.AI في إعداد هذا المعيار المرجعي، لكن النتائج تعود إلى جامعة ستانفورد وقد نُشرت كاملةً، مما يتيح لأي جهة تشكك في صحتها إعادة إجراء الاختبارات والتحقق منها بنفسها.
هذه هي النتيجة التي ينبغي أن تدفع المنطقة إلى إعادة النظر في النقاش برمته. يعرض الرسم البياني أدناه أفضل أداء حققه أي نموذج جرى تقييمه، وليس أداء نموذجنا أو نموذج أي جهة بعينها؛ إنه يمثل أعلى مستوى أداء بلغته النماذج المشمولة بالتقييم.
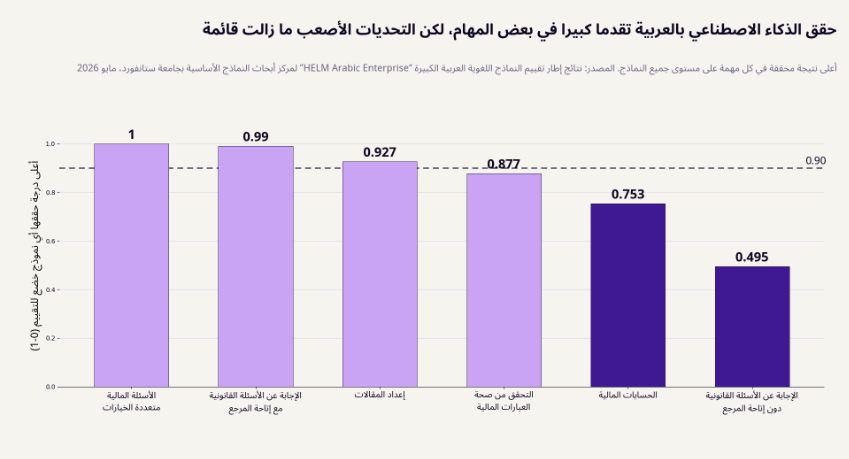
الشكل (4) — أعلى نتيجة حققها أي نموذج في كل مهمة. المصدر: نتائج إطار تقييم النماذج اللغوية العربية الكبيرة “HELM Arabic Enterprise” لمركز أبحاث النماذج الأساسية بجامعة ستانفورد، مايو 2026.
لقد وصل أداء النماذج في الأسئلة المالية متعددة الخيارات باللغة العربية إلى الحد الأقصى، حيث بلغت أفضل نتيجة الدرجة الكاملة 1.00. كما سجّلت النماذج 0.99 في الإجابة عن الاستفسارات القانونية مع إتاحة المراجع، بينما حقّقت 0.927 في إعداد المقالات المؤسسية.
لكن النتائج شهدت هبوطًا حادًا في المهام الأخرى، فأفضل نتيجة في الحسابات المالية لا تتجاوز 0.753. ولا تزال العمليات الحسابية التي لا يُستعان فيها بأدوات مساعدة غير موثوقة؛ وفي القطاع المالي، قد يكون الخطأ العددي صغيرًا في حجمه، لكنه ليس صغيرًا في أثره. أما الإجابة عن الأسئلة القانونية الإماراتية من دون إتاحة المرجع القانوني، فلا تتجاوز في أفضل حالاتها 0.495. وليست هذه نتيجة نموذج ضعيف، بل أفضل نتيجة حققها أي نموذج في التقييم كله، أي إن أحدث ما وصلت إليه النماذج في التعامل مع القانون الإماراتي، من دون إدراج النص التشريعي ذي الصلة في الأمر، لا يتجاوز -عمليًا- مستوىً يكاد يوازي التخمين العشوائي.
ومن الأهمية بمكان ألّا ننخدع بنتائج إعداد المقالات، فقد اعتمدت جامعة ستانفورد في تقييمها على ثلاثة محاور مستقلة (وهي الدقة والالتزام بالمصدر، والاكتمال، والالتزام بالأسلوب) انطلاقًا من إدراكها التام أن الفصاحة في اللغة العربية شيء، وصحتها ودقتها شيء آخر تمامًا. ومع أن أفضل نتيجة بلغت 0.927، أقحمت نماذج كثيرة معلومات لم ترد أصلًا في المصدر، فالفصاحة اللغوية لا تعني بالضرورة الموثوقية المعرفية؛ إذ قد تأتي الإجابة مصاغة بيقين تام، لكنها تحمل في طياتها خطأً فادحًا تترتب عليه تبعات قانونية أو تشغيلية جسيمة.
5. جودة المُدخلات تفوق في أهميتها مستوى ذكاء النظام المجرَّد
بمجرد وضع حالتي الإجابة عن الأسئلة القانونية جنبًا إلى جنب، يخرج النقاش حول السيادة الرقمية من دائرة التنظير البلاغي ليلامس صلب الواقع.
النماذج هي نفسها، والأسئلة هي ذاتها التي أعدّها خبراء قانونيون عرب، والفارق الوحيد الذي تعتمد عليه النتيجة هو ما إذا كان النص التشريعي مُدرجًا في الأمر أم لا. ففي حال إدراجه: تقفز النتيجة إلى 0.99. وفي حال عدم إدراجه: تهوي إلى 0.495، أي إن الأداء ينخفض إلى النصف تمامًا.
ويتكرر النمط ذاته في المهام المالية؛ فالتعرف على المفهوم المالي الصحيح في أسئلة الاختيار من متعدد يُحقق علامة كاملة (1.00)، في حين يتراجع الأداء عند احتساب النتيجة فعليًا إلى 0.753.
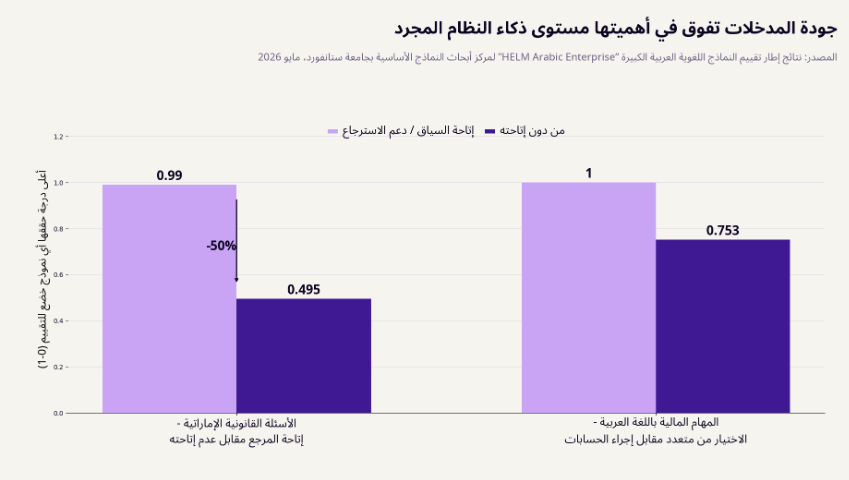
الشكل (5) — أثر السياق والأدوات المساندة في أداء المهام ذاتها. المصدر: نتائج إطار تقييم النماذج اللغوية العربية الكبيرة “HELM Arabic Enterprise” لمركز أبحاث النماذج الأساسية بجامعة ستانفورد، مايو 2026.
تعد هذه النتيجة الأكثر أهمية من الناحية العملية في إطار التقييم بأكمله، إذ تشير بوضوح إلى موضع الحل. فالفجوة بين 0.495 و0.99 لا يمكن سدها باستخدام نموذج أذكى، بل بنظام استرجاع قادر على التعامل بكفاءة مع وثائقك من لوائح تنظيمية وتعاميم وملفات عربية بصيغة PDF ممسوحة ضوئيًا وما تتضمنه من جداول وتنسيقات مختلفة. فالذكاء في هذه المنظومة لا يرتكز في قدرات النموذج اللغوي وحده، بل يشمل مراحل متعددة، منها استيعاب البيانات والاسترجاع وإسناد الإجابات إلى مصادرها وتحديد الحدود التي يُسمح للنظام بالعمل ضمنها.
ولهذا السبب تحديدًا، فإن “استخدام أفضل نموذج متاح” لا يشكِّل في حد ذاته استراتيجية فاعلة للذكاء الاصطناعي، كما أن اختزال السيادة الرقمية في “مكان استضافة الخادم” يعكس فهمًا قاصرًا لمفهوم السيادة. فإذا كانت منظومات الاسترجاع وحزمة تقنيات معالجة الكلام وأدوات فهم المستندات لديك قد بُنيت في الأصل لمعالجة النصوص الإنجليزية على شبكة الإنترنت، فلن تحقق النتائج المرجوة منها عند التعامل مع الوثائق العربية التي تقوم عليها أعمال مؤسساتك فعلًا، والأدهى من ذلك أنه لا توجد حتى دلائل على فشلها، وهو ما يجعله أشد أنواع الفشل خطورة.
6. لماذا يُعدّ التقييم العلني الركيزة الأساسية للتحسين
ثمة دلالة أخرى تنبثق عن تقييم النماذج اللغوية العربية الكبيرة “HELM Arabic” وتستحق من الاهتمام أكثر بكثير مما نالته حتى الآن.
فقد صَدَرت النسخة 1.0.0 من إطار التقييم العام للنماذج اللغوية العربية الكبيرة “HELM Arabic” وفيها خلل، إذ أُسقط السياق عند تقييم النماذج في مهام الإجابة عن الأسئلة القائمة على السياق ضمن معيارين من أصل سبعة. غير أن هذا الخلل سُرعان ما اُكتُشف، ووُثّق بشفافية من خلال طلبات السحب العامة، ثم صُحح في النسخة 2.0.0، وصدر به إفصاح رسمي مؤرخ في المنشور الأصلي ينبه القراء إلى أن الأرقام المنشورة سابقًا تعود لنسخة سابقة استُبدلت بنسخة أحدث.
وهذا الأمر ليس مدعاةً للإحراج، بل هو صُلب القضية وجوهرها.
فإطار التقييمات المغلقة لا يتيح مثل هذه الشفافية. والتقييم الذي يجريه المورّد ذاته يفتقر أصلًا إلى الدافع الذي يحثّه على الإقدام على مثل هذه الخطوة. أما إطار التقييم الذي ينشر كل أمر وكل رد من النموذج، ويوثّق إصداراته تباعًا، ويصحح أخطاءه على الملأ، فهو يرسّخ في تقييم الذكاء الاصطناعي باللغة العربية المبدأ ذاته الذي يدعو داريو أمودي جهات التقييم المستقلة إلى تطبيقه في مختبرات الذكاء الاصطناعي الرائدة: أي إخضاع الادعاءات للتمحيص والتدقيق من جانب طرفٍ خارجي لم يشارك في إطلاقها.
فما لا يمكن قياسه، لا يمكن تدقيقه. وما لا يمكن إسناده من الإجابات إلى أساس موثوق، لا يمكن تفسيره على نحو يمكن الوثوق به. وما لا تملك السيطرة عليه، لا تملك قرار إيقافه. ومن هذا المنطلق، فإن التقييم المستقل، بلغاتنا الأم وباستخدام بنيتنا التحتية، ليس ترفًا سياسيًا أو مطلبًا إضافيًا؛ بل ضرورة علمية.
7. ما دلالة ذلك بالنسبة للمنطقة؟
تحظى منطقة الشرق الأوسط بوفرة في رأس المال، وتشهد وتيرة استثنائية في تشييد البنية التحتية، وتضم حكومات على أتم الاستعداد للتحرّك وأخذ زمام المبادرة، وهي أيضًا موطن لأحد أكبر المجتمعات اللغوية في العالم. لكن هذه المقومات، مهما بلغت أهميتها، لا تكفل للمنطقة وحدها القدرة على التصرف باستقلالية وصنع القرار بشروطها. فهذه القدرة لا تأتي من تلقاء نفسها، بل تُبنى وتُكتسب؛ والأرقام سالفة الذكر تضع يدنا بدقة على مكامن بناء هذه القدرة.
وليس المطلوب هنا خوض سباق لإصدار أضخم نموذج مُدرب، بل بناء القدرات من خلال خمسة مستويات كشفت نتائج إطار التقييم اليوم مدى أهميتها:
- التمثيل اللغوي: تبنّي استراتيجية التجزئة اللغوية والنمذجة انطلاقًا من خصائص اللغة العربية في المقام الأول، لأن مشكلة تجزئة النص العربي مشكلة هيكلية، تتفاقم كلما طال المستند.
- الاسترجاع والمستندات: هنا تحديدًا يكمن أكبر عامل منفرد أثبت التقييم، بالأرقام، أثره في تحسين الأداء، إذ يصل الفارق إلى الضعف؛ لا في مجرد زيادة حجم النموذج.
- المعرفة المتخصصة: عدم تجاوز أفضل أداء في الإجابة عن الأسئلة القانونية الإماراتية من دون إتاحة المراجع سقفًا قدره 0.495 يحمل رسالةً مفادها أن ثمة فراغًا معرفيًا تعجز جميع النماذج الحالية عن سدّه، وهذه معرفة لا بد أن نبنيها نحن؛ فلن يأتي أحد من الخارج ليبنيها نيابة عنا.
- التقييم: تقييم علني، موثّق الإصدارات، بلُغتنا الأم، يمكن إعادة التحقق من نتائجه، ويقوم على عدم التردد في تصحيح أخطائه علنًا فور اكتشافها.
- إشراك الكفاءات الهندسية في صلب العمل: يمثل كل مستوى مما سبق منظومة تشغيلية قائمة بذاتها، ولا يمكن اختزالها في مجرد سلعة تُدرج ضمن طلبات الشراء.
لا تعني السيادة الرقمية أن نضع الذكاء الاصطناعي العالمي في كفة والمحلي في كفة أخرى لنختار بينهما، بل حريٌّ بنا أن نستفيد من أفضل النماذج في العالم، ونتعاون مع أفضل المختبرات، ونقارن أداءنا بما بلغته أحدث النماذج الرائدة، ونستقطب أفضل التقنيات إلى المنطقة، بيد أن الشراكات تكون أقوى بين الأنداد، والندية مرهونة بامتلاك القدرات.
واليوم، تُصرّح مختبرات الذكاء الاصطناعي الرائدة علنًا بأن تطور القدرات بات يسبق قدرتنا على التحكم فيها، وأن أولى خطوات العلاج تكمن في التقييم المستقل لها. وفي سياقٍ موازٍ، تؤكد الأدلة المستقاة من تقييمات اللغة العربية الحقيقة ذاتها: فما نعجز عن قياسه بلُغتنا، سنعجز حتمًا عن حوكمته داخل مؤسساتنا.
وهذا هو الجوهر الحقيقي للسيادة: فهي ليست كبحًا لعجلة التقدم، بل ضمانًا يتيح لنا —مهما تسارعت وتيرة التطور في العالم— أن نفهم مجريات التطور ونواكبها، ونمتلك الإرادة المطلقة لرفض الجوانب غير المقبولة منها.
المصادر
- Dario Amodei, We Must Pace the Frontier, darioamodei.com, 12 September 2026.
- Stanford CRFM, HELM Arabic Enterprise, 26 May 2026. crfm.stanford.edu/helm/arabic-enterprise/latest/
- Stanford CRFM, HELM Arabic, 18 December 2025, with erratum dated 3 June 2026. crfm.stanford.edu/helm/arabic/latest/
- W3Techs, content language usage statistics, June 2026.
- Second Language (Arabic) Acquisition of LLMs via Progressive Vocabulary Expansion, arXiv:2412.12310. Tokenizer fertility, word integrity, corpus token counts.
- Tracing Multilingual Representations in LLMs with Cross-Layer Transcoders, arXiv:2511.10840. Token-morpheme coherence, meaningless fragment rates.
- Cross-Lingual Empirical Evaluation of Large Language Models for Arabic Medical Tasks, arXiv:2602.05374. Model-native tokenizer fragmentation, Arabic vs English.